多 Agent 協作的資料一致性與高可靠架構設計
一句話重點:多 Agent 系統資料前後打架的根源是通訊架構缺乏狀態隔離與校驗,而非模型不夠聰明,因此要靠中心化共享狀態、經校驗的任務圖、節點 3 層校驗、交付前對帳與灰度評測發布,才能穩定上線。
關鍵觀點
- 把 500 億算成 1200 億這類錯誤,問題出在 Agent 之間用自由文本點對點傳話:下游拿不到原始事實只能自己猜,彙總時又不知道該信誰,所以改 Prompt 或換模型都治不了根。
- 資料層用中心化共享狀態,加上強型別、按角色隔離寫入權限與版本記錄;任務層讓大模型生成的依賴圖先經程式化校驗,再以欄位裁減與工具白名單約束每個節點。
- 錯誤要在源頭就攔下:節點寫回前過契約、證據鏈、一致性 3 層校驗,失敗就地重試一般限制在 2 次以內、再不行走降級分支,異常不外溢;交付前再用全局事實對帳把無依據的數據標記待核實或過濾。
- 核心節點出錯時保存狀態快照並通知人工介入,修正後從中斷處接著跑,不必整條重來;非核心任務則超時或反覆出錯就降級,優先讓主幹跑通。
- 上線後靠 Trace ID 追蹤與量化指標讓調優有客觀依據;任何提示詞、工具或 DAG 修改都要先過評測回歸與灰度發布,避免局部改動拖垮整條鏈路。
分段摘要
0:35案例導入與四大結構性問題
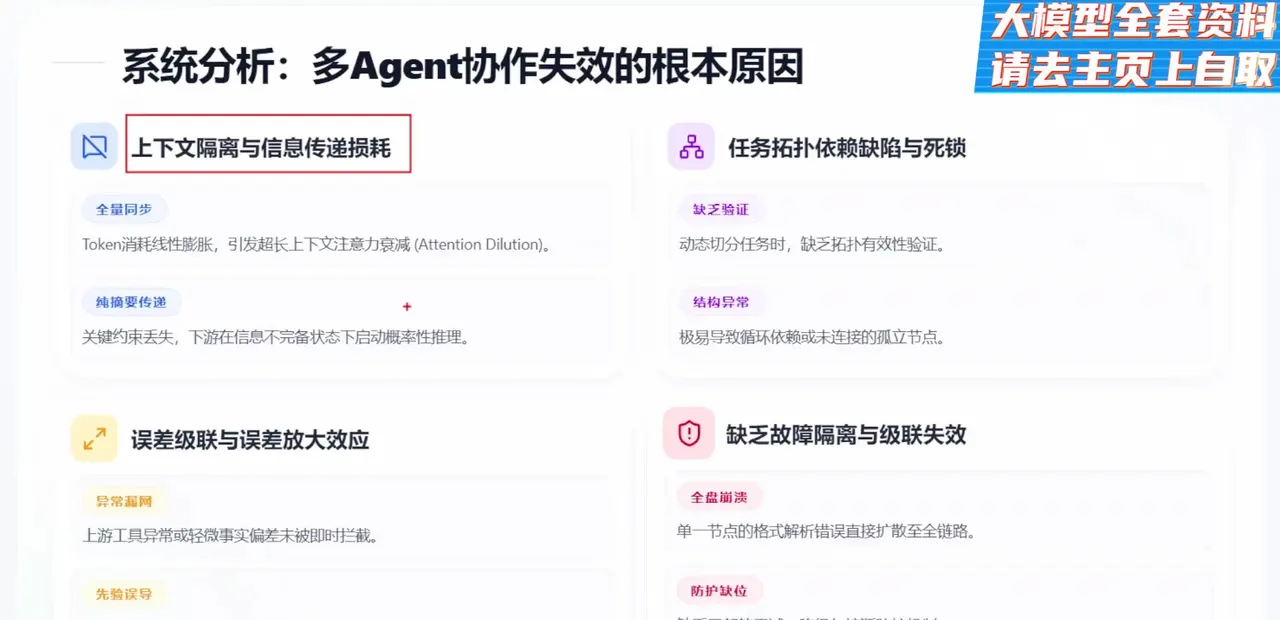
以研報生成為例,4 個 Agent 分別負責規劃大綱、搜尋數據、計算分析與撰寫報告,結果搜尋到的基準市場規模是 500 億,分析 Agent 算成 800 億,寫作 Agent 的摘要卻寫成 1200 億。症結不在模型聰明與否,而在通訊架構缺少狀態隔離與校驗關卡。拆開鏈路可見 4 個結構性問題:上下文傳遞兩難、動態任務拆分缺拓樸校驗易死鎖、上游錯誤像滾雪球般擴散,以及缺乏局部容錯與兜底降級。
▶ 從這裡看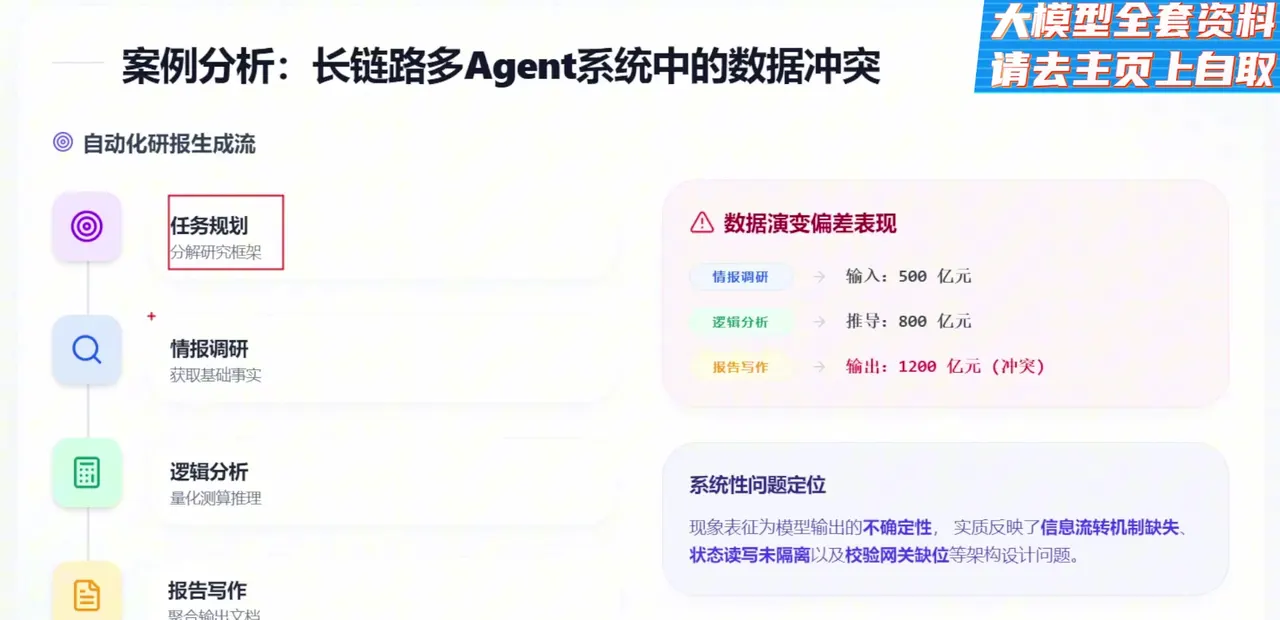
3:35中心化共享狀態與三規範
解方是不再讓 Agent 以自由文本點對點傳話,改為中心化共享狀態空間統一讀寫,並遵守 3 項規範:以 Pydantic 強型別約束每個業務欄位,按角色隔離寫入權限(調研只能寫原始事實、分析只能寫自己的分析欄位),以及每次讀寫自動記錄版本號與寫入節點,讓問題可回溯到源頭。
▶ 從這裡看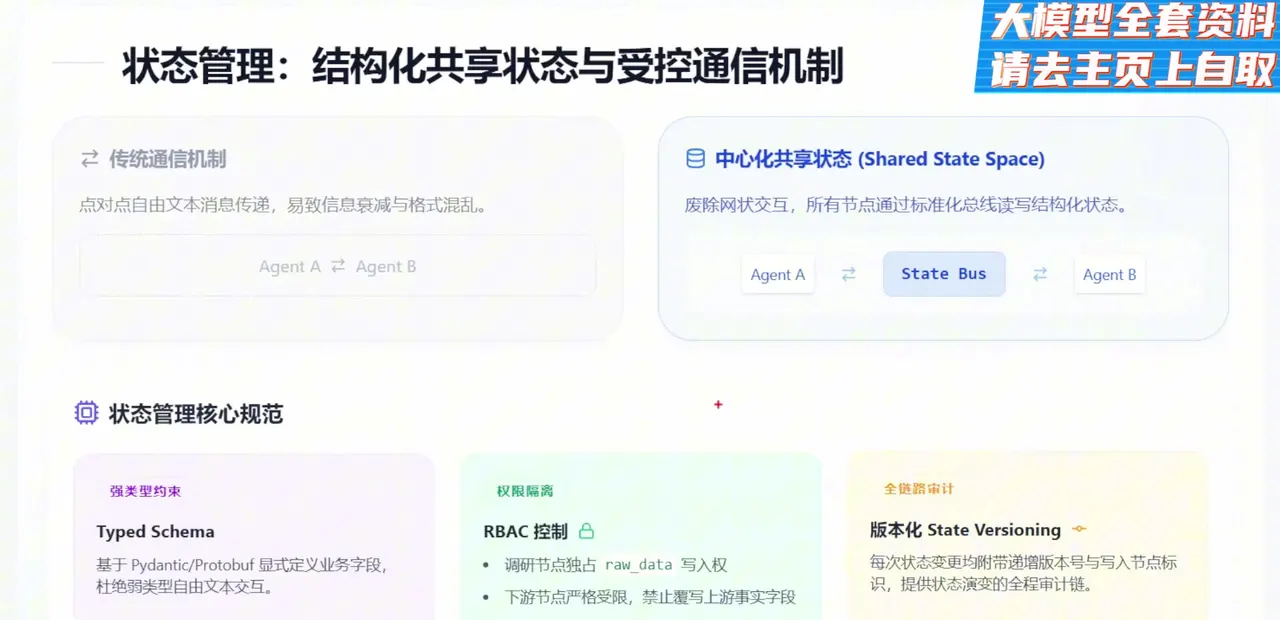
5:05任務依賴圖校驗與執行防護
大模型生成的任務依賴圖不能直接執行,要先經程式化校驗器做有向無環檢測(排除循環依賴與死鎖)、連通性檢查(每個子任務都有輸入來源與輸出目標)與語義重複任務合併。執行階段再約束節點行為:只推送分析節點所需的欄位以節省 token,並以工具白名單限制調用範圍(例如調研節點只開放檢索、不給程式執行權限),避免越權造成資料污染。
▶ 從這裡看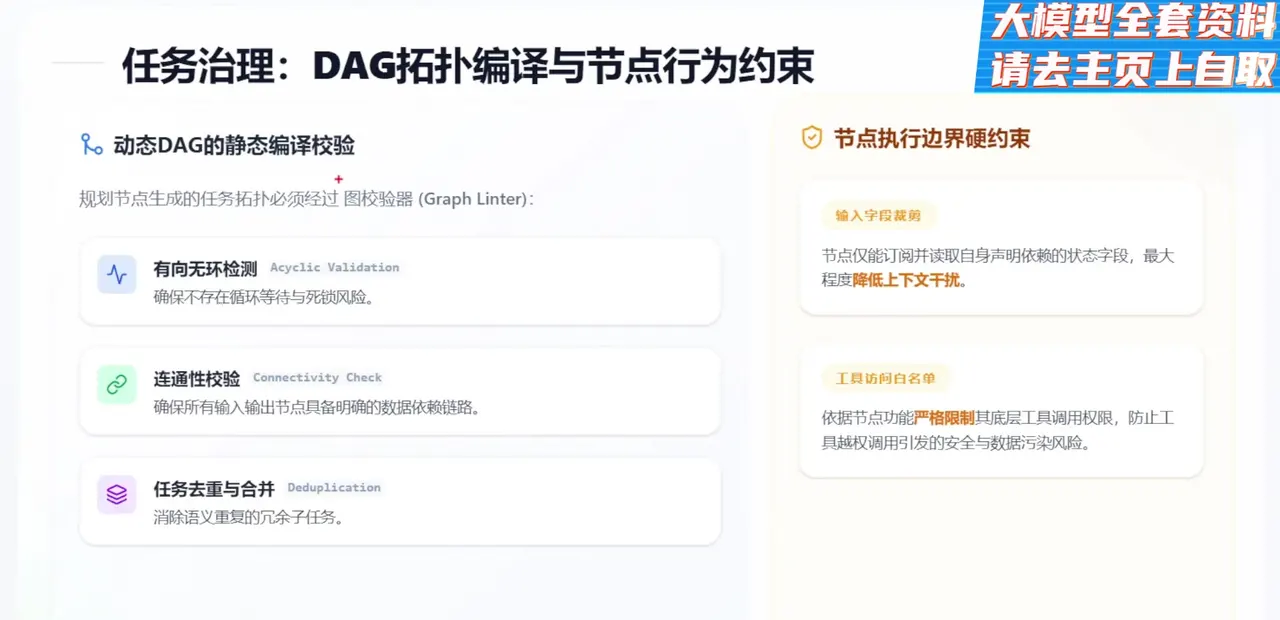
6:15節點三層校驗與重試降級
節點寫回共享狀態前要過 3 層校驗:契約校驗(格式是否符合預設結構,JSON 解析失敗就地攔截)、證據鏈對齊(關鍵數據在檢索內容中找不到支撐即判異常)、一致性比對(推導結論與共享狀態既有事實是否邏輯衝突)。任一層未通過,就把錯誤原因打包成診斷資訊回傳,讓節點局部重試,上限一般在 2 次以內;仍不過就走降級分支,例如填入預設值或跳過非核心步驟,讓異常鎖在單一節點內,不影響下游。
▶ 從這裡看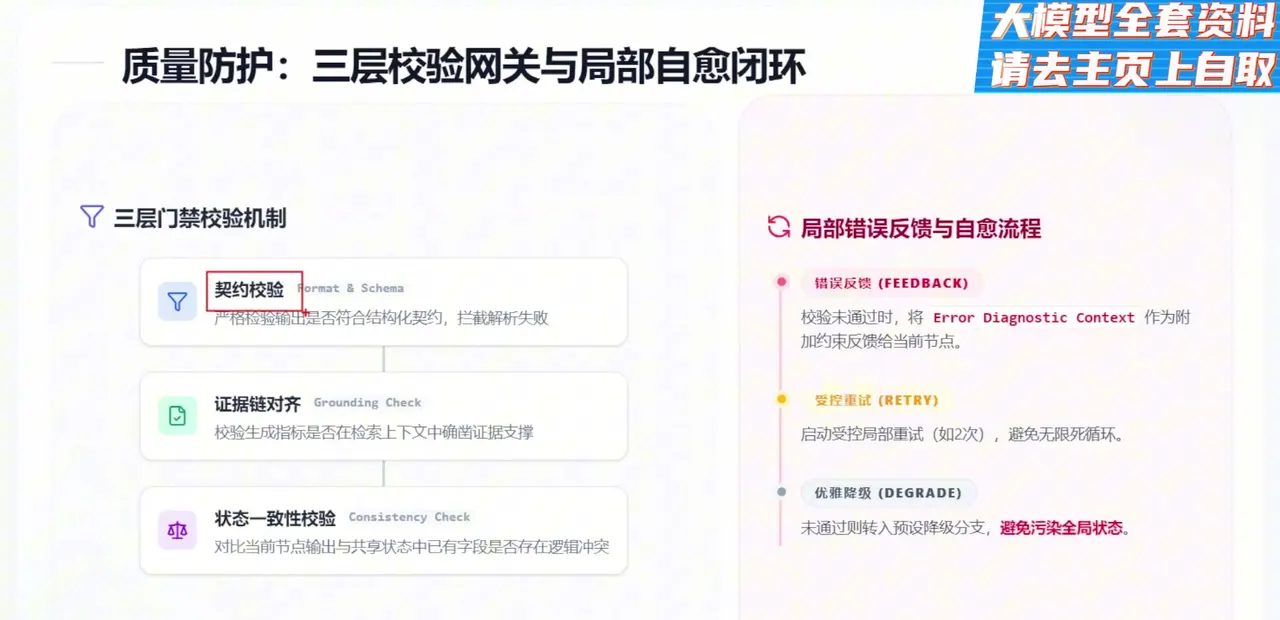
7:35全局事實對帳與熔斷容錯
報告交付前先做全局事實對帳,把稿中每個核心數據與關鍵結論反向比對共享狀態,找不到依據的就標記待核實或直接過濾。同時為每個節點設定超時時間與重試上限:非核心任務超時或反覆出錯就降級,優先讓主幹跑通;核心節點出錯、系統無法自行處理時,則保存狀態快照並通知人工介入,確認或修正後可接續執行,不必從頭重跑整個流程。最後點出系統要長期維護,可觀測性不可少。
▶ 從這裡看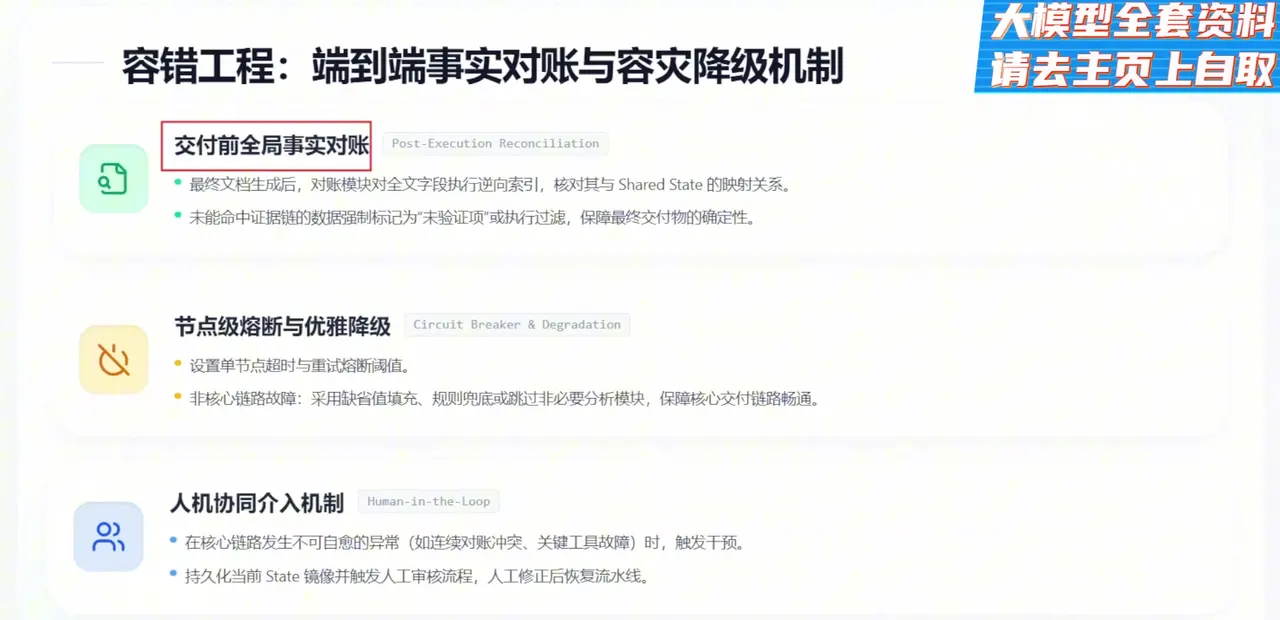
8:55可觀測性追蹤與量化指標
每次任務觸發都會產生全域唯一的 Trace ID,各 Agent 的操作(調用工具、讀寫狀態)記成 Span,形成清楚的時間線視圖。據此建立量化指標:數據一致性達成率看校驗關卡攔截多少次異常,各節點 Token 消耗占比找出無效耗用,鏈路執行耗時分布定位效能瓶頸,讓調優基於客觀數據而不是靠感覺瞎猜。
▶ 從這裡看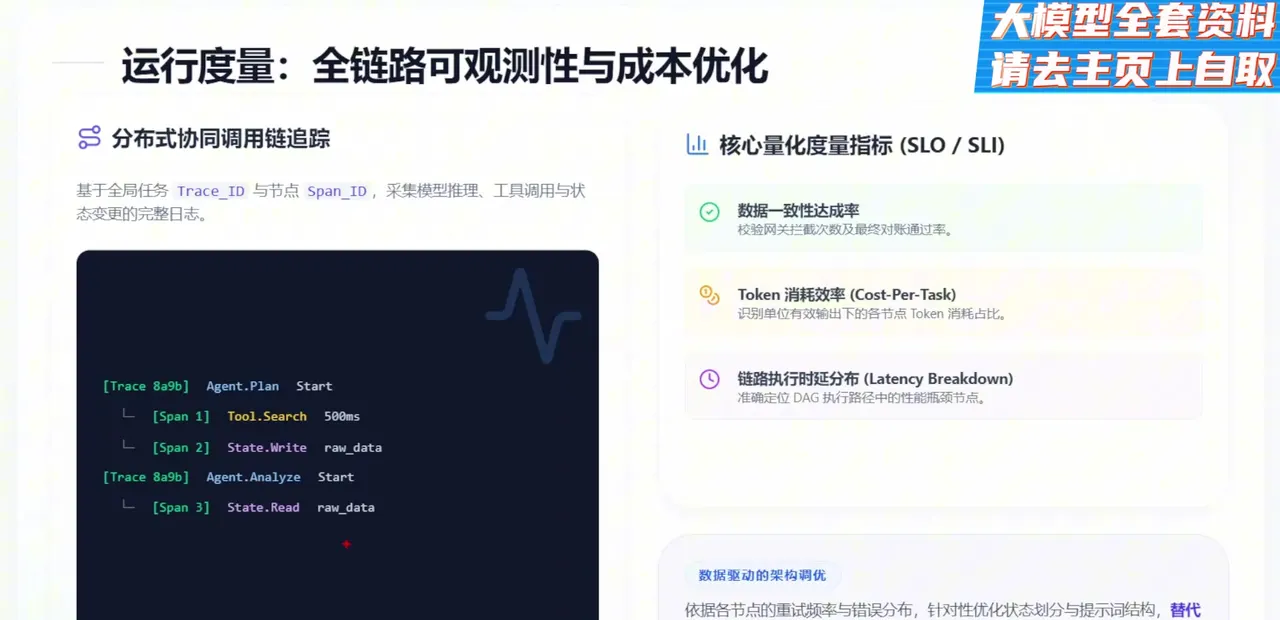
10:15評測回歸與灰度發布流程
發版前建立標準化評測資料集,涵蓋典型任務、長上下文多跳推理與刻意刁難的異常輸入,每次發版自動跑回歸測試,看一致性是否達標、任務完成率有無下降、平均單任務調用成本有沒有失控。提示詞、工具編排或 DAG 的修改不能直接上線,要先靜態編譯校驗,再用基準資料集回放確認沒有退化;上線走灰度發布,先接少量真實流量觀察,指標平穩再逐步全量。
▶ 從這裡看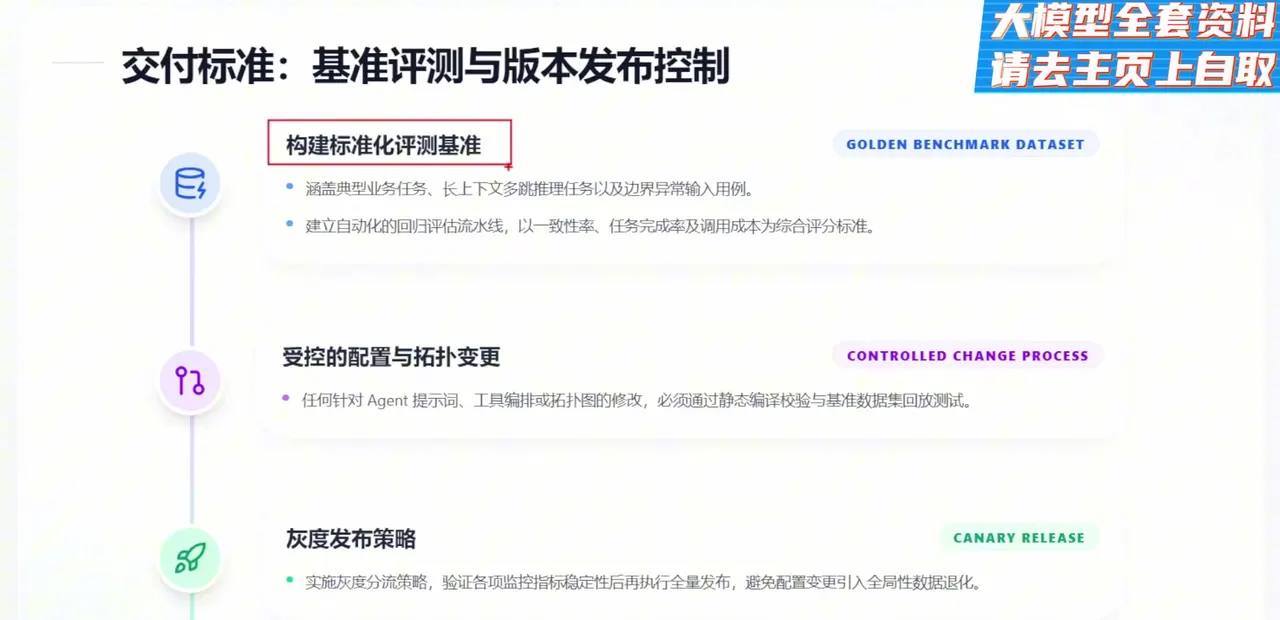
11:15多智能體工程實踐總結
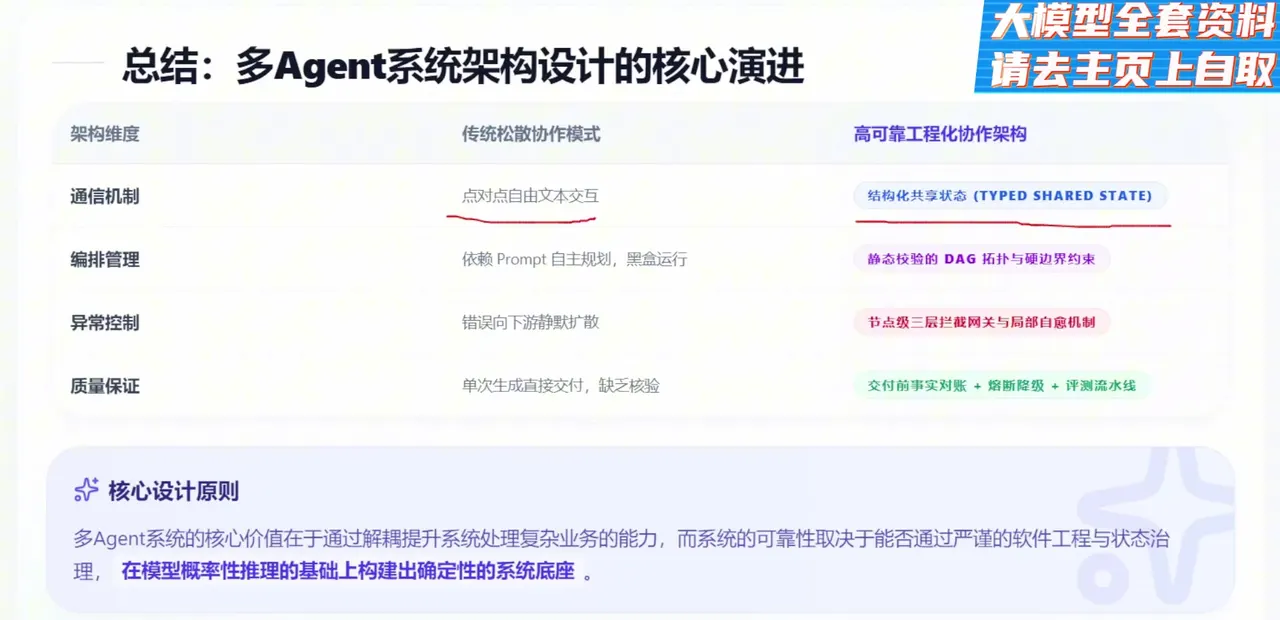
總結對比:通訊機制從自由文本傳話改為結構化共享狀態,搭配強型別與權限隔離;任務編排從全憑模型自主規劃、黑盒運行,改為經靜態校驗的 DAG,並劃定節點的輸入與工具邊界;異常控制從錯誤一路往下擴散,改為關鍵節點 3 層校驗加就地重試與降級把問題鎖在局部;交付品質則增加全局事實對帳、熔斷降級與自動化評測流水線。多 Agent 的價值在於任務解耦處理複雜業務,能否穩定落地,取決於能否以軟體工程與狀態治理手段,在模型推理之上建出確定可靠的系統底座。
▶ 從這裡看